
GEO(생성형 엔진 최적화) 전략: 도입보다 먼저 확인해야 할 AI 유입의 진짜 가치
GEO 제안서는 쏟아지지만 정작 자사 색인 상태를 아는 조직은 드뭅니다. AI 유입의 질을 데이터로 따져 보고, 그 관심이 성과로 이어지려면 무엇이 먼저 갖춰져야 하는지 정리했습니다.
2026년 9월 15일부터 클라우드플레어에 새로 등록하는 사이트는 AI 봇 기본값이 바뀌었습니다. 광고가 붙은 페이지에서 학습용 봇과 에이전트 봇은 막고, 검색용 봇은 열어 두는 방식입니다. 다만 검색과 학습을 함께 맡는 Googlebot, bingbot, Applebot은 학습 차단 기본값의 영향을 받을 수 있습니다. 이제 AI 봇을 막을지 말지가 아니라, 어떤 용도의 봇을 막을지를 정해야 합니다.
그런데 봇의 정체는 GA4만으로는 확인하기 어렵습니다. GA4는 방문자의 User-Agent나 IP를 보여 주지 않아서, 사람이 아닌 것으로 보이는 방문을 찾아내더라도 그것이 어느 회사의 어떤 봇인지는 알 수 없습니다. 봇의 이름은 서버 로그에 있습니다. 이 글에서는 로그에 찍힌 이름을 용도로 읽는 방법, 그 이름이 진짜인지 확인하는 방법, 그리고 이름을 밝히지 않고 들어오는 브라우저 조작형 AI가 어떻게 보이는지까지 차근차근 알아보겠습니다. 챗GPT와 클로드, 제미나이, 퍼플렉시티에 실제로 페이지를 열게 해서 로그에 무엇이 남는지도 함께 확인했습니다.
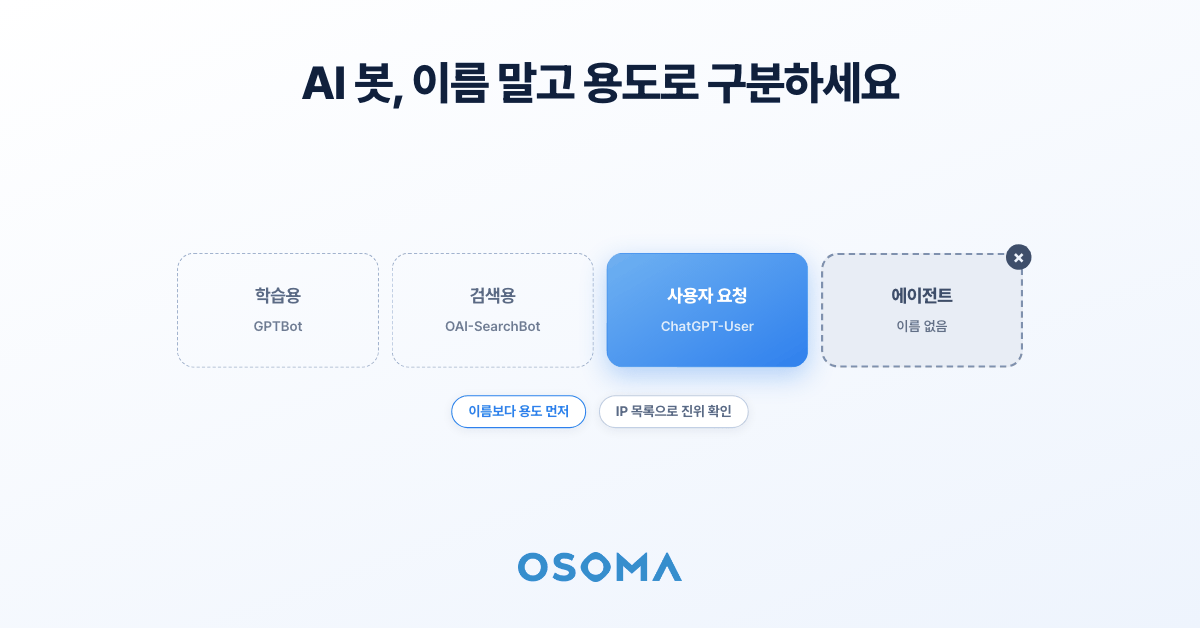
AI 회사의 봇은 하는 일에 따라 이름이 나뉩니다. 공식 문서를 기준으로 보면 크게 네 가지입니다.
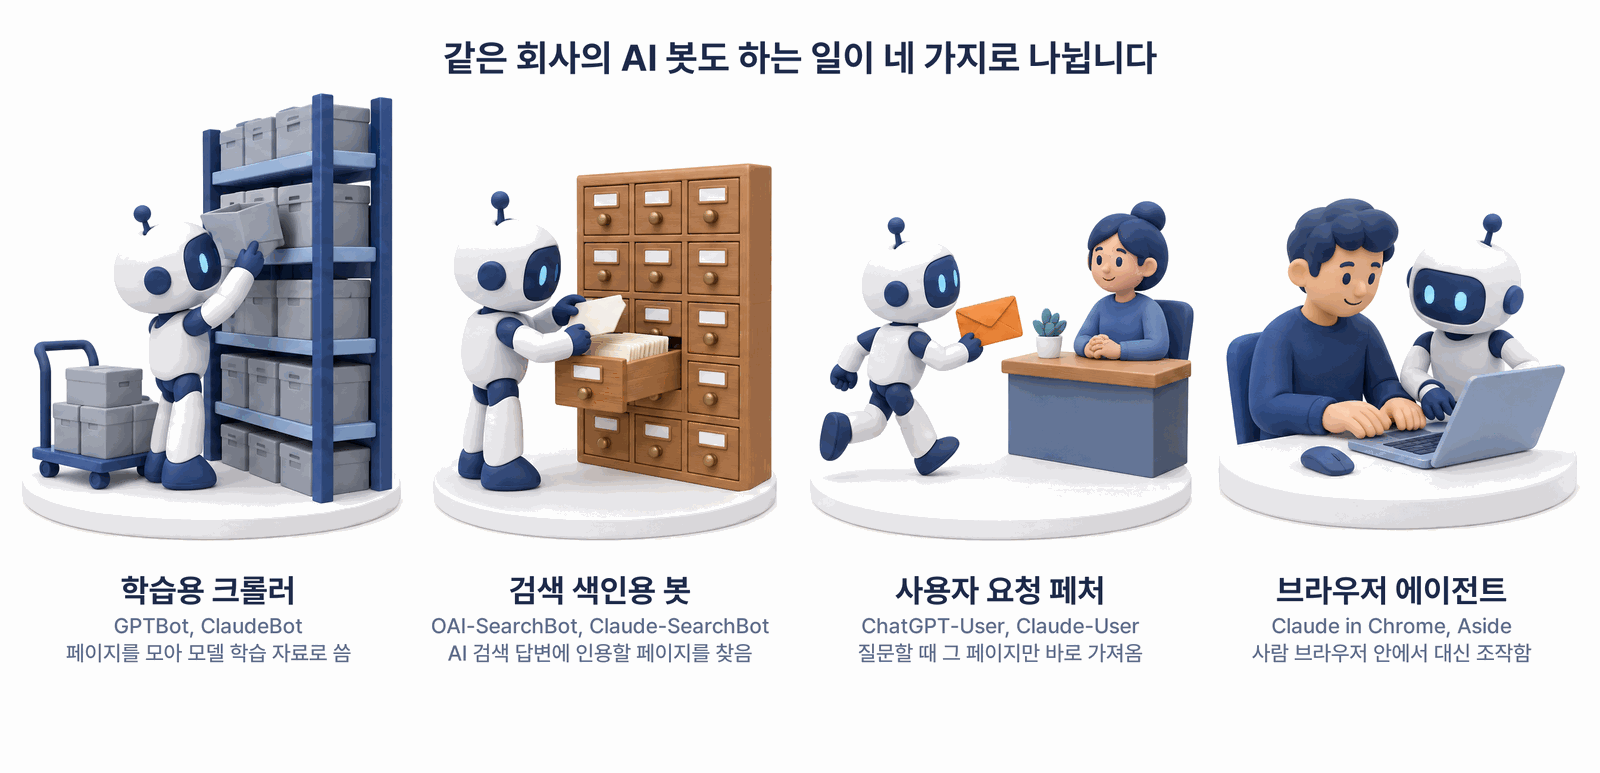
첫 번째는 학습용 크롤러입니다. 웹 페이지를 모아 AI 모델을 학습시키는 데 씁니다. 두 번째는 검색 색인용 봇으로, 챗GPT 검색이나 퍼플렉시티 같은 AI 검색이 답변에 인용할 페이지를 미리 모아 둡니다. 세 번째는 사용자 요청 페처입니다. 사람이 채팅창에 주소를 붙여 넣거나 질문을 하면 그때 필요한 페이지만 가져옵니다. 네 번째는 브라우저 에이전트입니다. 페이지를 받아 가는 데 그치지 않고 브라우저를 열어 사람처럼 클릭하고 입력합니다.
| 용도 | 대표적인 봇 이름 | 막았을 때 달라지는 것 |
|---|---|---|
| 학습용 크롤러 | GPTBot, ClaudeBot, meta-externalagent, CCBot | 앞으로의 모델 학습 자료에서 빠짐 |
| 검색 색인용 봇 | OAI-SearchBot, Claude-SearchBot, PerplexityBot | 해당 AI 검색 답변에 인용되지 않음 |
| 사용자 요청 페처 | ChatGPT-User, Claude-User, Perplexity-User | 고객이 건넨 주소를 AI가 읽지 못함 |
| 브라우저 에이전트 | Google-Agent, 챗GPT 클라우드 브라우저 | AI가 대신 하던 작업이 멈춤 |
오픈AI와 앤트로픽, 퍼플렉시티는 용도마다 이름을 따로 붙여 두어서 로그의 이름만으로도 용도가 드러납니다. 구글과 애플은 사정이 다릅니다. 크롤러는 Googlebot과 Applebot 하나씩이고, 학습에 쓸지는 Google-Extended와 Applebot-Extended라는 별도 토큰으로 정합니다. 이 토큰은 robots.txt에서만 쓰는 이름이라 서버 로그에는 찍히지 않습니다. 마이크로소프트는 코파일럿 전용 봇이 따로 없고, bingbot 하나가 빙 검색과 코파일럿 답변을 함께 맡습니다.
가장 흔한 오해는 학습용 봇을 막으면 AI 검색에서도 빠진다는 생각입니다. 오픈AI는 GPTBot과 OAI-SearchBot 설정이 서로 독립적이라고 문서에 적어 두었습니다. GPTBot을 막아도 챗GPT 검색 답변에는 계속 인용될 수 있고, 반대로 OAI-SearchBot을 막으면 학습과 상관없이 검색 답변에서 빠집니다. 국내 지식iN에는 AI 검색에 나오려면 GPTBot과 ClaudeBot을 허용해야 한다는 답변이 채택되어 있었는데, 둘 다 학습용이라 검색 노출과는 관계가 없습니다.
구글 쪽에도 비슷한 오해가 있습니다. Google-Extended를 막으면 AI 개요에서 빠진다고 생각하기 쉬운데, 구글은 이 토큰이 제미나이 학습과 그라운딩에 쓸지를 정할 뿐이고 검색 노출이나 순위에는 영향을 주지 않는다고 밝힙니다. AI 개요와 AI 모드는 일반 검색과 마찬가지로 Googlebot 규칙을 따릅니다.
세 번째 오해는 이름을 하나씩 적어 허용하는 방식에서 생깁니다. robots.txt 마지막에 모든 봇을 막는 규칙을 두고 필요한 봇만 이름으로 열어 두면, 나중에 새로 생긴 봇은 자동으로 막힙니다. 오픈AI가 광고 랜딩 페이지를 심사하는 OAI-AdsBot을 새로 내놓았을 때, 국내 커머스 사이트 네 곳이 이 구조 때문에 광고 심사 봇까지 막고 있었다는 분석이 나왔습니다.
세 경우 모두 이름과 용도를 한 묶음으로 본 데서 생깁니다. 로그를 읽을 때도, 막을지 열지 정할 때도 이름보다 용도를 먼저 봐야 하는 이유입니다.
네 가지 가운데 성격이 가장 다른 것이 사용자 요청 페처입니다. 사람이 직접 요청했다는 이유로 여러 회사가 이 봇을 robots.txt의 예외로 두고 있습니다.
| 회사 | 봇 이름 | 공식 문서의 표현 |
|---|---|---|
| 오픈AI | ChatGPT-User | robots.txt 규칙이 적용되지 않을 수 있음 |
| 구글 | 사용자 트리거 페처 | 일반적으로 robots.txt를 무시함 |
| 퍼플렉시티 | Perplexity-User | 일반적으로 robots.txt를 무시함 |
| 메타 | meta-externalfetcher | robots.txt 규칙을 우회할 수 있음 |
| 앤트로픽 | Claude-User | 예외 문구 없음, 자사 봇이 robots.txt를 따른다고 밝힘 |
그래서 GPTBot을 막았는데도 챗GPT가 우리 글을 읽어 갔다면, 대개 규칙을 어긴 것이 아닙니다. 사용자가 주소를 붙여 넣으면 ChatGPT-User가 그 페이지를 가져가고, 이 요청은 학습용 봇 차단과 무관하게 움직입니다. 이 경로까지 막고 싶다면 robots.txt가 아니라 서버나 CDN에서 끊어야 하는데, 그러면 고객이 AI에게 우리 페이지를 보여 주며 질문하는 길도 함께 닫힙니다. 막을지 말지는 결국 어느 쪽 손해가 더 큰지 따져서 정할 문제입니다.
봇의 이름표에 해당하는 User-Agent 문자열은 요청을 보내는 쪽이 마음대로 적을 수 있습니다. 누구든 자기 요청에 GPTBot이라고 쓸 수 있다는 뜻입니다. 봇 탐지 업체 데이터도미(DataDome)가 약 70만 개 사이트에 가짜 챗GPT 이름을 달아 요청을 보냈더니 79.7%가 그대로 통과시켰다는 보고도 있습니다.
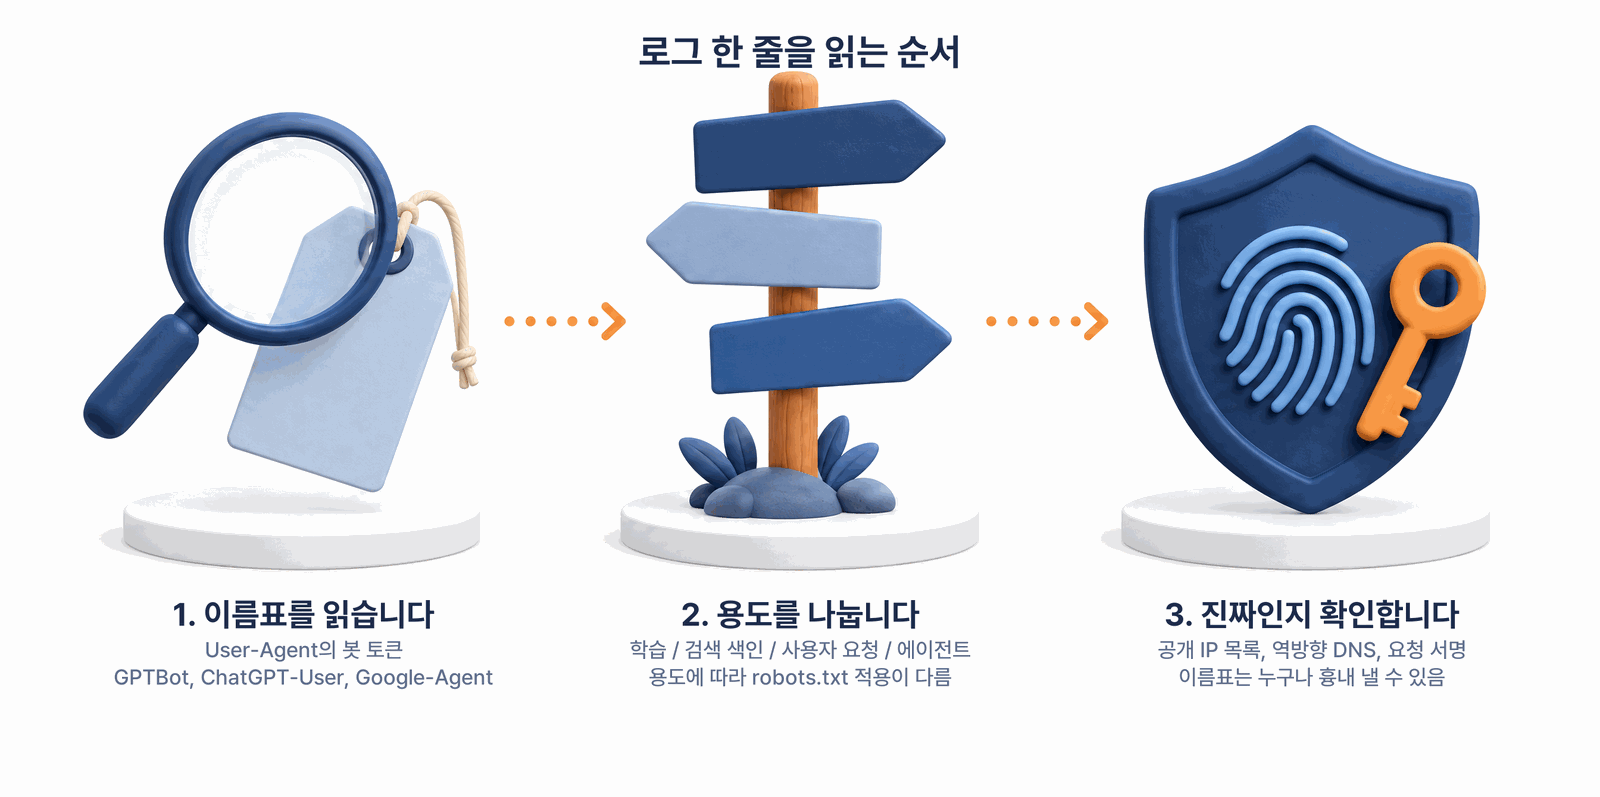
그래서 로그를 읽는 순서는 세 단계가 됩니다. 이름을 읽고, 그 이름으로 용도를 나누고, 마지막으로 진짜인지 확인합니다. 확인 방법은 회사마다 다른데, 오픈AI와 앤트로픽, 구글, 퍼플렉시티는 봇의 IP 목록을 공개하고 있어서 로그의 IP가 목록 안에 있는지 대조하면 됩니다. 애플과 네이버는 IP 목록과 함께 역방향 DNS 조회도 안내하고, 메타와 바이트댄스는 공식 확인 방법이 없습니다.
여기서 자주 혼동하는 것이 IP 소유자입니다. 오픈AI의 봇은 대부분 마이크로소프트 애저 위에서 돌기 때문에 IP 소유자를 조회하면 마이크로소프트가 나옵니다. 누구의 봇인지는 IP 소유자가 아니라 공개된 목록에 들어 있는지로 판단해야 합니다.
실제로 확인해 봤습니다. 작성자가 운영하는 블로그에 요청 정보를 기록하는 장치를 붙이고, 챗GPT와 클로드, 제미나이, 퍼플렉시티에 같은 페이지를 열어 요약해 달라고 요청했습니다.
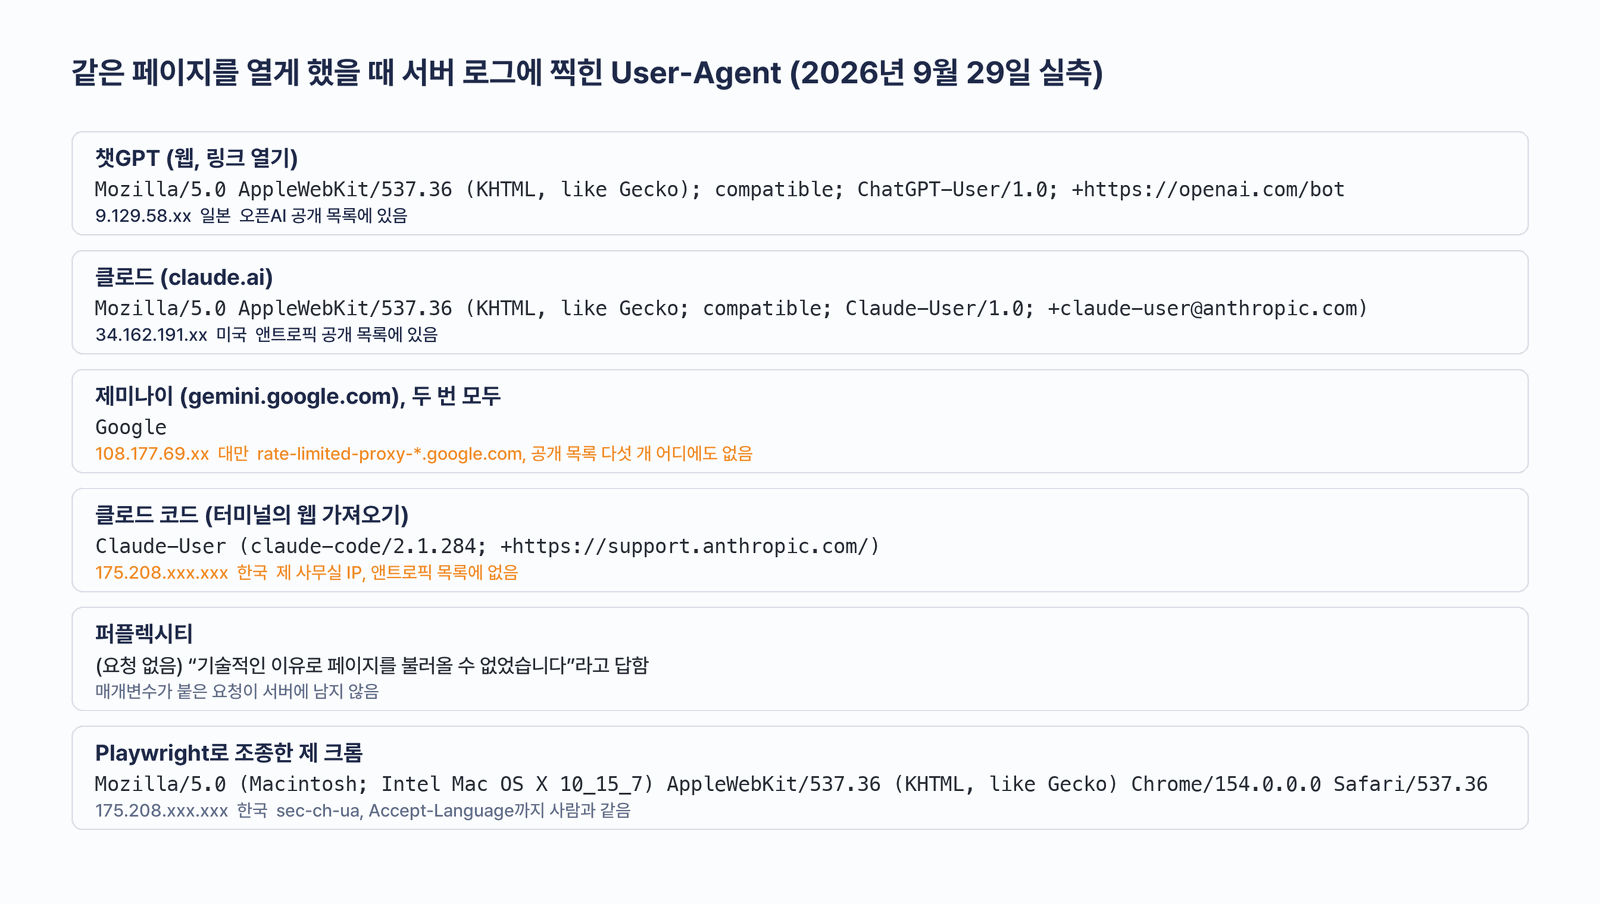
챗GPT와 클로드는 문서대로였습니다. 각각 ChatGPT-User와 Claude-User라는 이름으로 들어왔고, IP도 두 회사가 공개한 목록 안에 있었습니다. 제미나이는 달랐습니다. 두 번 요청했는데 두 번 모두 이름이 그냥 “Google”이었고, 구글이 공개한 IP 목록 다섯 개 어디에도 그 주소가 없었습니다. 구글 인프라에서 온 요청이라는 것까지는 확인되지만, 공개된 IP 목록만으로는 진짜인지 가릴 수 없습니다. 퍼플렉시티는 이번 시도에서는 페이지를 불러올 수 없었다고 답했고 서버에도 요청이 남지 않았습니다.
이름과 출발지가 어긋나는 경우도 있었습니다. 터미널에서 쓰는 클로드 코드로 같은 페이지를 열었더니 이름은 Claude-User였는데, 요청은 앤트로픽 서버가 아니라 작성자의 사무실 PC에서 나갔습니다. 이름만 보고 집계하면 이런 요청까지 AI 회사의 방문으로 잡힙니다.
여기까지는 적어도 이름을 밝히고 들어오는 봇이었습니다. 사람 대신 브라우저를 열어 클릭하고 입력하는 AI는 이름을 밝히지 않는 경우가 많습니다. 이 방문은 서버에 도착하는 방식이 세 가지이고, 방식마다 남는 흔적이 다릅니다.
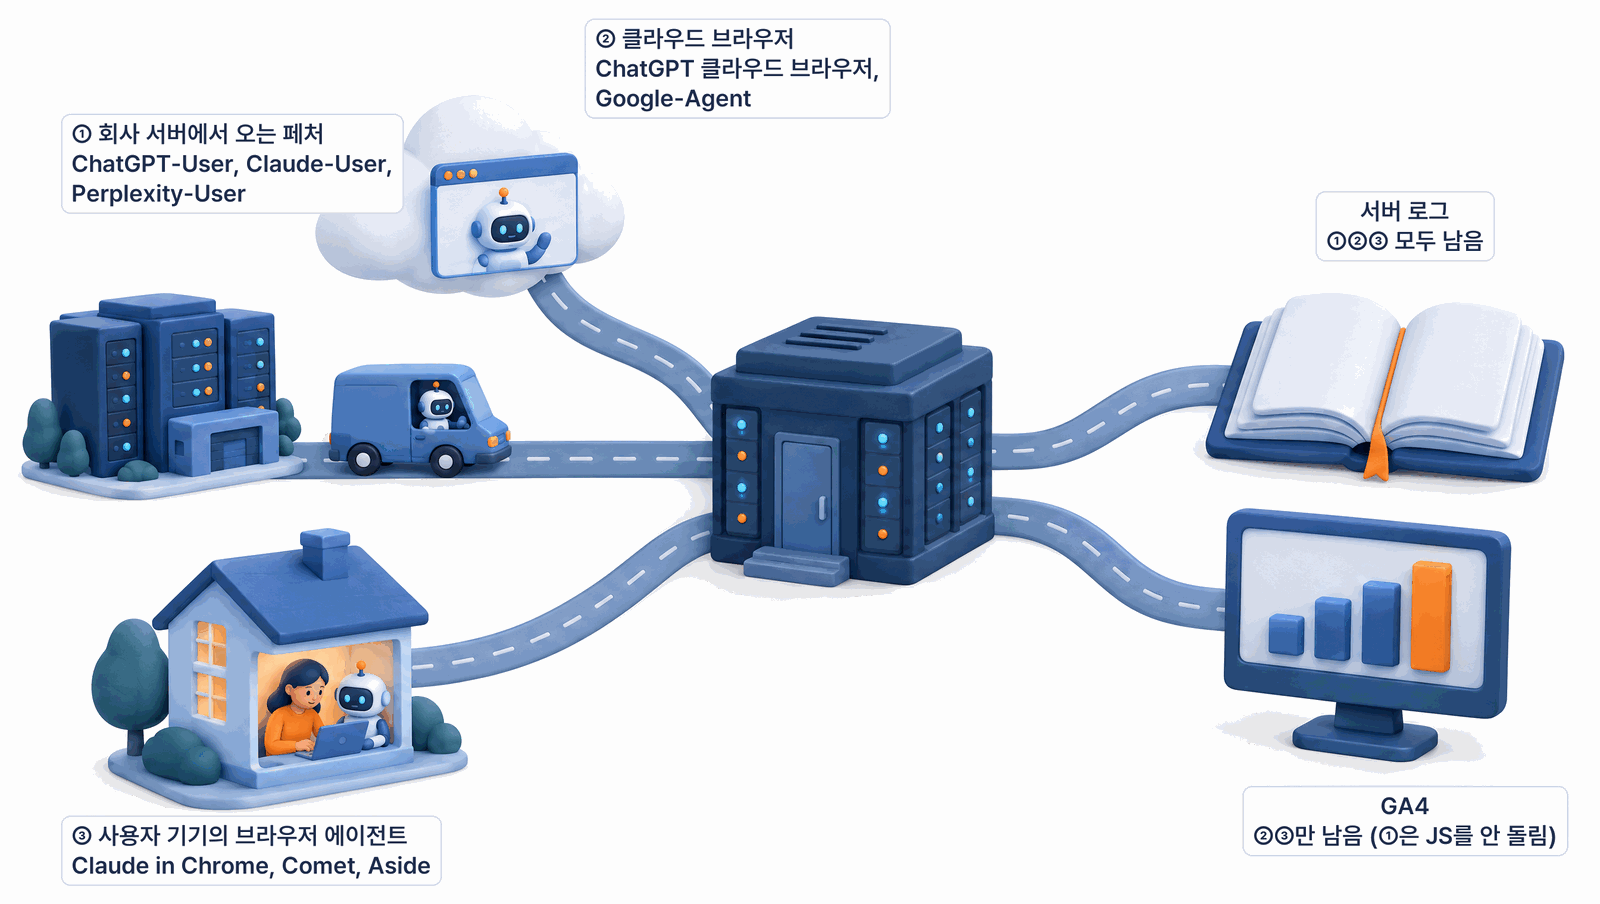
첫 번째는 AI 회사 서버가 페이지만 받아 가는 방식입니다. 앞에서 본 ChatGPT-User와 Claude-User가 여기 해당하고, 이름이 찍히니 로그에서 구분됩니다. 대부분 자바스크립트를 실행하지 않아서 GA4에는 기록이 남지 않습니다.
두 번째는 AI 회사의 클라우드에 있는 브라우저가 페이지를 실제로 열고 조작하는 방식입니다. 구글의 Google-Agent는 이름을 밝히고 IP 목록도 공개했습니다. 챗GPT의 클라우드 브라우저는 이름 대신 요청마다 서명을 붙이는데, 오픈AI 도움말은 이 트래픽을 Signature-Agent라는 헤더로 확인하라고 안내합니다. 이 헤더를 읽을 수 있는 CDN이나 서버 설정이 있어야 보인다는 뜻입니다. 자바스크립트가 실행되니 GA4에도 세션이 생기고, 직접 유입으로 잡힐 가능성이 높습니다.
세 번째가 가장 구분하기 어렵습니다. 사용자의 컴퓨터에 설치된 브라우저 안에서 AI가 움직이는 방식입니다. 앤트로픽의 Claude in Chrome, 퍼플렉시티의 코멧, 크롬에 들어간 제미나이 자동 탐색, 그리고 어사이드(Aside) 같은 AI 브라우저가 여기 해당합니다. 오픈AI도 전용 브라우저 Atlas를 2026년 8월 9일에 종료하고 같은 기능을 챗GPT 데스크톱 앱과 크롬 확장으로 옮겼습니다.
이 방식이 까다로운 이유는 모든 것이 사용자의 것이기 때문입니다. 사용자의 크롬에서, 사용자의 로그인 상태로, 사용자의 인터넷 주소로 들어옵니다. 어사이드는 공식 사이트와 도움말에서 작업과 데이터가 사용자 기기에 남는다고 밝히고, 사이트가 보안 문자(CAPTCHA)나 추가 인증을 요구하면 사용자가 직접 풀고 작업을 이어 간다고 안내합니다. 이름을 바꾸거나 자신을 알리는 표시를 붙인다는 언급은 문서 어디에도 없습니다. 자동화 도구로 크롬을 조작해 같은 페이지를 열어 봤을 때도, 로그에 찍힌 정보는 사람이 직접 연 것과 다르지 않았습니다.
이 방문을 구분하려는 시도가 없는 것은 아닙니다. 요청에 서명을 붙이는 방식(Web Bot Auth)이 2026년 9월 국제 인터넷 표준화 기구 IETF의 작업반 문서로 채택되었지만 아직 표준은 아니고, 서명을 붙이는 곳도 오픈AI, 구글, 아마존 등 일부에 그칩니다. 페이지 안에서 스크롤과 입력 패턴으로 구분하는 연구도 나오고 있지만, 이 역시 서버 로그가 아니라 페이지 안에서 측정해야 합니다.
세 방식을 서버 로그와 GA4에 나란히 놓으면 이렇게 정리됩니다.
| 방식 | 서버 로그 | GA4 |
|---|---|---|
| AI 회사 서버의 페처 | 봇 이름으로 구분됨 | 남지 않음 |
| 클라우드 브라우저 | 이름이나 서명으로 구분 가능 | 세션이 생기고 직접 유입으로 잡힐 가능성이 높음 |
| 사용자 기기의 브라우저 에이전트 | 사람과 구분되지 않음 | 사람의 세션과 구분되지 않음 |
앞의 실험에서도 챗GPT와 클로드, 제미나이가 페이지를 가져간 직후 GA4 실시간 보고서를 열어 봤지만, 요청이 온 일본과 미국, 대만의 방문은 보이지 않았습니다. 적어도 이번 실험에서는 첫 번째 방식이 서버 로그에만 남았습니다.
결국 어느 한 도구로 AI 방문 전체를 볼 수는 없습니다. 이름을 밝히는 봇은 서버 로그가, AI 답변을 읽고 사람이 눌러 들어온 방문은 GA4의 AI 어시스턴트 채널이 보여 주고, 사용자 브라우저 안의 에이전트는 지금으로서는 어느 쪽에서도 따로 보이지 않습니다. GA4에서 참여율이 유난히 낮거나 사람이 쓰지 않는 화면 크기로 들어오는 방문을 발견했다면, 그 방문이 이 가운데 어디에 속하는지는 서버 로그와 함께 놓고 봐야 알 수 있습니다.
정리하겠습니다. AI 봇을 막을지 말지 논의하기 전에 먼저 할 일은 로그에 찍힌 봇 이름이 어떤 용도인지 파악하는 것입니다. 같은 회사의 봇이라도 학습용과 검색용, 사용자 요청용은 막았을 때의 결과가 서로 다르고, 사용자 요청은 애초에 robots.txt 밖에서 움직입니다. 그 이름이 진짜인지는 공개된 목록과 대조해야 알 수 있고, 실험에서 본 것처럼 문서에 없는 이름으로 들어오는 경우도 있습니다.
이름을 밝히지 않고 들어오는 방문은 앞으로 더 늘어날 가능성이 큽니다. AI 브라우저는 사람의 브라우저를 그대로 쓰기 때문에 서버 로그에서도 GA4에서도 사람으로 보입니다. 지금 이름이 보이는 봇부터 제대로 구분해 두어야, 나중에 구분되지 않는 방문이 늘었을 때 그 크기라도 가늠할 수 있습니다.
지금 확인해 볼 만한 항목을 정리하면 다음과 같습니다.
한 가지 덧붙이면, 이 구분은 기술 담당자만의 일이 아닙니다. 어떤 봇을 막으면 AI 검색 인용(GEO 성과)이 줄고, 어떤 경로를 끊으면 고객이 AI에게 우리 페이지를 보여 주며 묻는 길이 닫힙니다. 그 결과로 달라지는 데이터는 마케팅 보고서에 나타나는데, 정작 설정은 인프라 쪽에서 트래픽 부담을 기준으로 정하는 경우가 많습니다. 로그를 봇의 용도별로 나눠 읽을 수 있어야 두 팀이 같은 기준으로 이야기할 수 있습니다.
다음 글에서는 이런 AI 방문을 GA4 같은 트래픽 분석 도구에서 어떻게 찾아내고 분석할 수 있는지 다뤄 보겠습니다.
GEO 제안서는 쏟아지지만 정작 자사 색인 상태를 아는 조직은 드뭅니다. AI 유입의 질을 데이터로 따져 보고, 그 관심이 성과로 이어지려면 무엇이 먼저 갖춰져야 하는지 정리했습니다.
1:1 상담으로 시작할 수 있습니다.